开源配音与训练自己的声音:播客该用什么模型怎么部署
2026年11月12日整理的开源配音与音色训练实用指南,面向想做配音播客、并想训练自己声音的人。国内覆盖通义千问 Qwen3-TTS(官方 0.6B / 1.7B,Base 模型写明 3 秒快速克隆并可微调,端到端时延低至 97ms)、Fun-CosyVoice3-0.5B(官方评测表与训练、部署脚本)和 IndexTTS-2.5(官方写明单条参考音频零样本克隆,2026年8月10日发布)。海外与社区方案覆盖 GPT-SoVITS(官方写明 5 秒零样本、1 分钟微调,并公布 v2 ProPlus 在 4060Ti / 4090 / M4 CPU 上的 RTF)以及 Fish Audio 的 S2-Pro 与 Drama 3(S2-Pro 官方写 10 到 30 秒参考音频,可部署于消费级 GPU,但未公布具体显存)。规格均以当天仍有效的官方仓库为准,不编造未公布的显存和速度。
想做配音播客,并希望用自己的声音来念稿,开源方案已经能在自己的电脑上跑起来。关键是把两条路分开:一条是零样本克隆,准备一段参考音频就让模型读新稿;另一条是微调或训练,用更干净的自己的声音数据,把音色推得更稳。本文按 2026 年 11 月 12 日仍有效的官方页面整理国内外常用方案,只写官方已经公布的参数、数据门槛和测评条件,不编造显存占用和速度。
01先选路,再选模型
零样本克隆的门槛最低,适合先听像不像、能不能用于节目试音。微调或训练通常能提高相似度和稳定性,但要准备数据、时间和显卡。不少官方仓库两条能力都提供,差别主要在:参考音频要多长、有没有现成的训练脚本、许可证是否允许你用于节目分发。商用或公开上线前,务必再核对各仓库当前许可,尤其是预训练权重和代码许可不一致的项目。
02国内:Qwen3-TTS、CosyVoice 3 和 IndexTTS-2.5
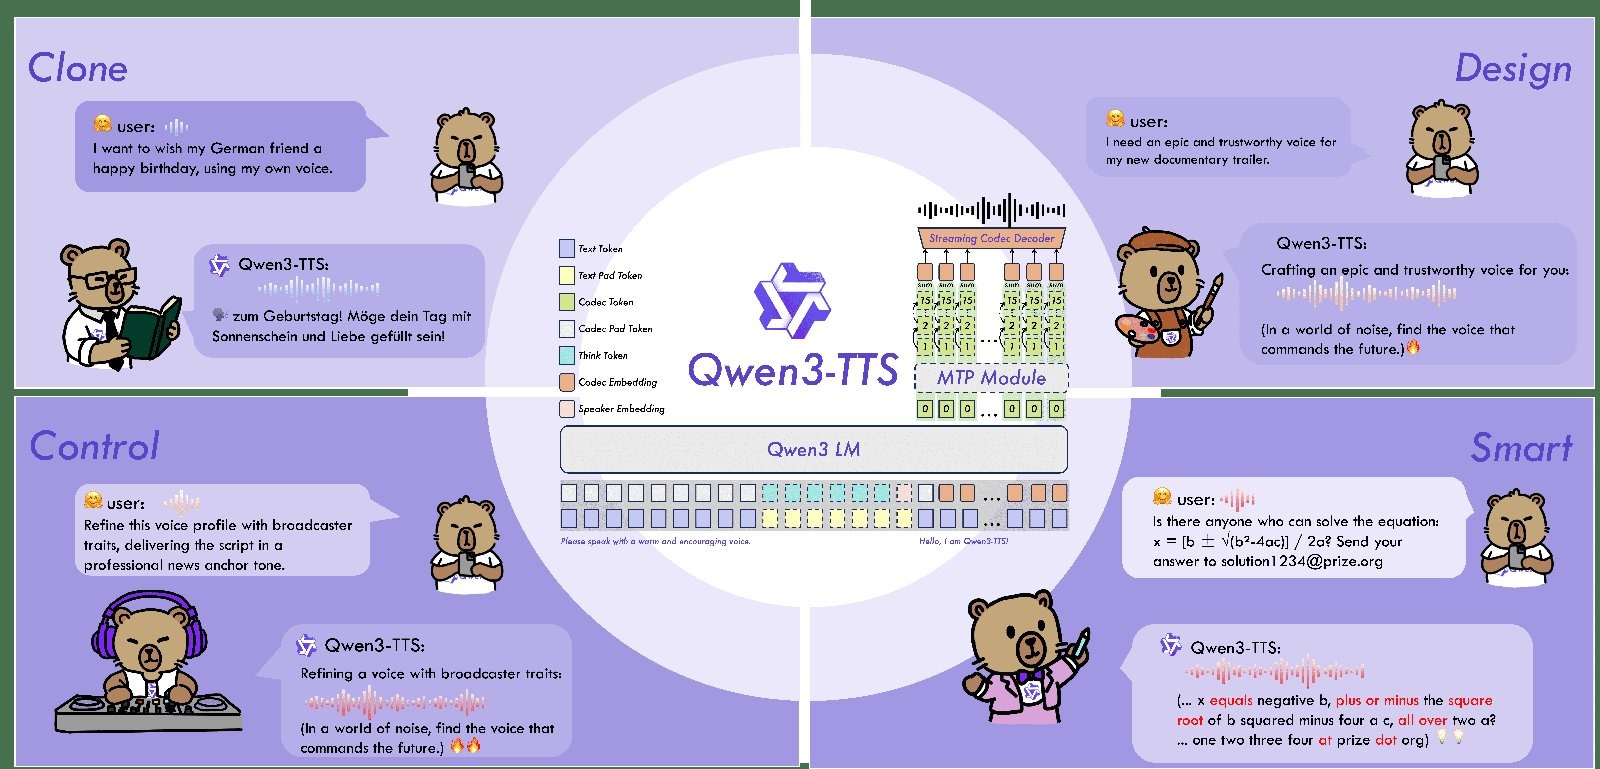
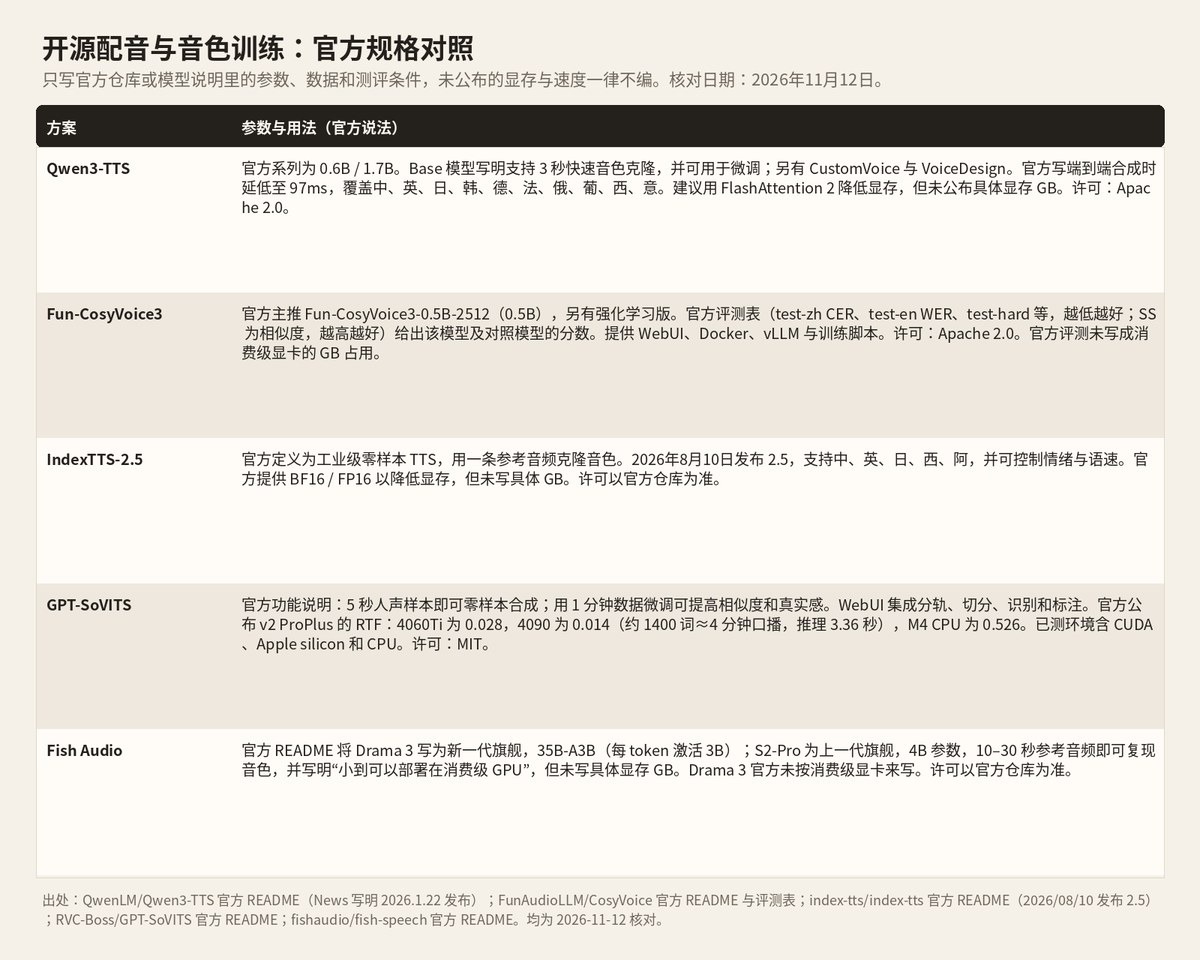
通义千问 Qwen3-TTS 是 2026 年仍在维护的国产开源方案。官方仓库在 2026 年 1 月 22 日宣布发布基于 Qwen3-TTS-Tokenizer-12Hz 的 0.6B / 1.7B 系列,许可为 Apache 2.0,仓库最近一次推送记录为 2026 年 3 月 17 日。官方把权重分成三类:CustomVoice 提供官方音色和指令控制,1.7B 版写明有 9 种官方音色;VoiceDesign 用自然语言描述来设计声音;Base 模型则写明“支持 3 秒快速音色克隆,并可用于微调”。语言覆盖中、英、日、韩、德、法、俄、葡、西、意。官方还写明采用双轨混合流式架构,可在输入单个字符后立即输出首包音频,端到端合成时延低至 97ms。部署方面,官方提供 Python 包、本地 Web 演示和 vLLM,并建议使用 FlashAttention 2 降低显存,但没有公布具体需要多少 GB,因此本文不估计这个数字。想训练自己的声音,官方另有微调文档 Qwen3-TTS-Finetuning。
同一语音开源体系里,FunAudioLLM 的 CosyVoice 也值得当作可训练方案。官方仓库最近一次推送为 2026 年 5 月 25 日,许可为 Apache 2.0,官方现在主推 Fun-CosyVoice3-0.5B-2512,参数量 0.5B,并同时提供强化学习版。官方 README 的评测表在 test-zh、test-en、test-hard 上报告了字错误率或词错误率(越低越好)以及相似度 SS(越高越好),并列出 F5-TTS、Index-TTS2 等对照模型。例如官方表中 Fun-CosyVoice3-0.5B-2512 的 test-zh CER 为 1.21、SS 为 78.0,强化学习版 test-zh CER 为 0.81;这是官方测评,不是本文自测。使用上,官方提供 Web 演示、Docker、vLLM,以及 examples 目录中的训练和推理脚本。官方评测没有写成某张消费级显卡占用多少显存。
如果目标就是“一条参考音频克隆自己的声音”,并希望控制情绪和语速,可以看 IndexTTS。官方把它写成工业级可控、高效的零样本文本转语音系统,用一条参考音频克隆音色。最新版本 IndexTTS-2.5 于 2026 年 8 月 10 日发布,支持中文、英语、日语、西班牙语和阿拉伯语,提供细粒度情绪控制、0.5 倍到 2.0 倍语速控制,以及拼音、音素和假名等发音控制,官方写明推理快于 IndexTTS-2。仓库最近一次推送记录为 2026 年 9 月 29 日。官方提供 Web 演示、Python 接口和 vLLM 服务,并说明可使用 BF16 或 FP16 降低显存、加快推理,但未公布具体 GB。许可以官方仓库为准。
03数据很少也能训练:GPT-SoVITS;消费级部署还要看 Fish Audio
更在意“数据很少也能训练自己的声音”时,GPT-SoVITS 的官方说明非常具体。官方功能写明:输入 5 秒人声样本即可零样本合成;用 1 分钟训练数据微调,可以提高音色相似度和真实感。它提供 WebUI,集成人声伴奏分离、训练集自动切分、中文识别和文本标注,降低了从原始录音做到可训练数据的门槛,并支持中、英、日、韩、粤等跨语种推理。许可为 MIT。官方还公布了 GPT-SoVITS v2 ProPlus 的实时率:在 4060Ti 上为 0.028,在 4090 上为 0.014,并写明约 1400 词相当于 4 分钟口播、推理时间为 3.36 秒;在 M4 CPU 上为 0.526。这是官方写明测试条件的速度。已测环境还包括 Apple silicon 和 CPU。仓库在 2026 年 11 月 11 日仍有推送。
Fish Audio 的官方仓库在 2026 年 11 月 11 日仍有更新。官方 README 将 Drama 3 写为新一代旗舰,参数为 35B-A3B(每 token 激活 3B),并提供 Hugging Face 权重;S2-Pro 为上一代旗舰,4B 参数,官方写明 10 到 30 秒参考音频即可复现音色,并且“小到可以部署在消费级 GPU”,但没有写具体显存 GB。Drama 3 官方没有按消费级显卡来标,因此有消费级显卡、想按官方字面部署的人,应先看 S2-Pro。许可以官方仓库为准。另外,F5-TTS 官方写明代码为 MIT,但预训练权重因训练数据 Emilia 采用 CC-BY-NC 许可,不能把官方预训练权重直接当成可商用方案。
04播客场景可以怎么选、怎么用
- 先验证自己的声音像不像:用 Qwen3-TTS Base 的 3 秒克隆,或 IndexTTS 的单条参考音频,或 GPT-SoVITS 的 5 秒零样本,先出一条样音再决定要不要训练。
- 已经决定训练自己的音色,而数据大约只有一分钟:优先看 GPT-SoVITS 官方写明的小样本微调,并用它的 WebUI 做分轨、切分和标注。
- 有整理好的数据和训练经验:再看 Qwen3-TTS 或 CosyVoice 3 官方仓库中的微调与训练文档;两者都是 Apache 2.0,也提供 Web 或演示入口。
- 只有消费级显卡、希望官方明确写了“能在消费级 GPU 上部署”:Fish Audio 官方对 S2-Pro 有这一句,但未给具体显存;Drama 3 不要按消费级方案来理解。
- 部署从各项目官方 GitHub 安装,用官方 Web 界面或 Python 接口。官方没有写具体显存的,就不要按第三方传言去买卡;商用或公开分发前,再核对当前许可证,尤其是 F5-TTS 这类代码与权重许可不同的项目。
一句话收束:2026 年 11 月 12 日能核对到的官方事实是,先试听可以用 Qwen3-TTS 的 3 秒克隆或 IndexTTS 的单条参考音频;数据很少就训练,GPT-SoVITS 官方写的是 5 秒零样本、1 分钟微调;要走完整训练与部署栈,可看 CosyVoice 3 和 Qwen3-TTS 的官方文档。具体显存很多项目没有公布,本文也就此止步,不以猜测代替官方说明。
收藏与收听进度仅保存在本机。