电商自己部署开源生图:普通电脑8到24GB显卡该怎么选
2026年11月12日整理的开源生图实用指南,面向电商等需要大量出图、并打算在自己电脑上部署模型的人。国内覆盖通义 Z-Image-Turbo(官方写明 6B、8 步、可舒适运行于 16G 显存消费级设备)、通义千问 Qwen-Image / Qwen-Image-2512(20B,Apache 2.0,官方写明 DiffSynth-Studio 可在 4GB 显存内卸载推理)和混元图像 3.0(80B 总参数、13B 激活,官方推荐显存为 3×80GB 或 8×80GB)。海外以 FLUX.2 [klein] 4B 为主(官方写明约 13GB 显存、Apache 2.0,端到端最快可到 1 秒以内)。文中按 8GB / 12GB / 16GB / 24GB 分档,只写官方已公布的规格,不编造速度和显存占用。规格均以 2026年11月12日仍有效的官方仓库和模型卡为准。
做电商、日常要大量出图的人,最常问的不是“哪个模型演示最好看”,而是:能不能装在自己电脑上,8GB、12GB、16GB、24GB 显卡分别能跑什么,中文海报和商品图怎么选。本文按 2026 年 11 月 12 日仍能打开的官方页面整理当前还在维护的开源方案,国内、海外都覆盖。官方没写的显存占用和速度,一律不编。
01为什么要自己部署
电商出图是重复劳动:主图、场景图、详情页、活动海报,还希望同一件商品在不同背景里保持一致。在线接口上手快,但量大之后,费用、排队,以及商品图是否留在自己这边,都会变成实际问题。自己部署的好处是可以把模型版本和工作流钉死,批量出图时结果更可复现,数据也可以留在本地。代价也很明确:要有合适的显卡和磁盘,还要看许可证是否允许商用,不能把“权重能下载”直接理解成“可以随便用于商品图”。
02怎么部署:三条官方都写了的路
第一条,用各模型官方 GitHub 仓库里的推理脚本:克隆仓库、按说明安装依赖、从 Hugging Face 或 ModelScope 下载权重。第二条,用 Hugging Face Diffusers。FLUX.2 [klein]、Z-Image-Turbo、Qwen-Image 的官方说明都给出了 Python 示例。第三条,用 ComfyUI 搭可视化工作流。Qwen-Image 官方仓库写明 2025 年 8 月 5 日起已在 ComfyUI 中得到原生支持;FLUX.2 官方模型卡也写明已进入 ComfyUI 和 Diffusers。国内下载权重,优先看各仓库给出的 ModelScope 链接。
装之前先看许可证。通义 Z-Image、通义千问 Qwen-Image、FLUX.2 [klein] 4B 的官方说明均为 Apache 2.0。FLUX.2 [klein] 9B 与 32B 的 FLUX.2 [dev] 使用 FLUX 非商用许可证,本地商用要另看官方条款,不能把开源权重直接当成可商用。混元图像 3.0 的许可以其官方仓库为准。
03国内:先看能在消费级显卡上落地的 Z-Image,再看 Qwen-Image 和混元 3.0
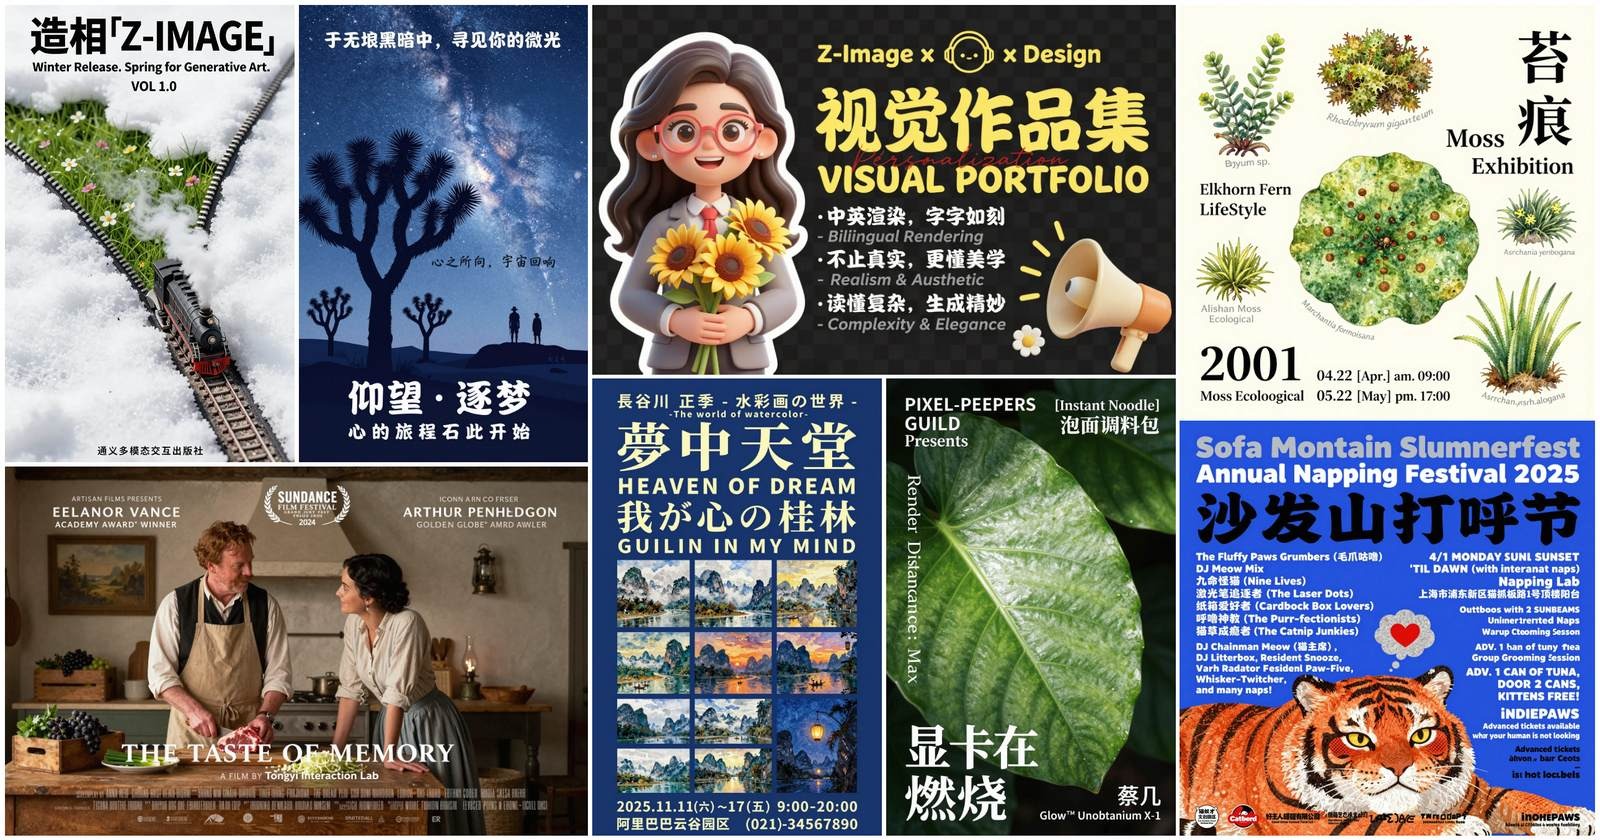
普通电脑上,国内模型应先看阿里通义的 Z-Image(造相)。官方仓库写明这是 6B 参数的高效生图家族。2026 年 11 月 12 日核对官方模型表:已经放出权重的是 Z-Image 基础模型和蒸馏版 Z-Image-Turbo;Z-Image-Edit 与 Z-Image-Omni-Base 仍写“待发布”,不能当成现在就能下载的方案。Turbo 官方写明只需 8 次函数评估,可舒适运行于 16G 显存消费级设备,擅长真实感图像和中英文文字渲染,并强调指令遵循。企业级 H800 上,官方写的是亚秒级延迟,这不是消费级显卡的成绩,不能混着读。仓库最近一次推送记录为 2026 年 2 月 9 日,许可为 Apache 2.0。对电商海报、促销字和中文标签来说,官方强调的双语文字能力是关键。
需要更强中文文字,或要把生成和精细编辑放在同一条产品线上,应看通义千问 Qwen-Image。官方仓库把它写成 20B 参数的 MMDiT 图像基础模型,强调复杂文字渲染和精确图像编辑,代码与权重按 Apache 2.0 开源。2025 年 12 月 31 日发布的 Qwen-Image-2512 是当前官方推荐的文生图权重;编辑侧则有 Qwen-Image-Edit-2511 等版本,支持多图输入。2026 年 2 月 10 日,官方宣布推出下一代 Qwen-Image-2.0,并指向博客和 Qwen Chat 试用,但那条更新没有像 2512 那样同时给出可下载的开源权重链接,因此本地部署仍以已经放出的 Qwen-Image、Qwen-Image-2512 和对应编辑模型为准。
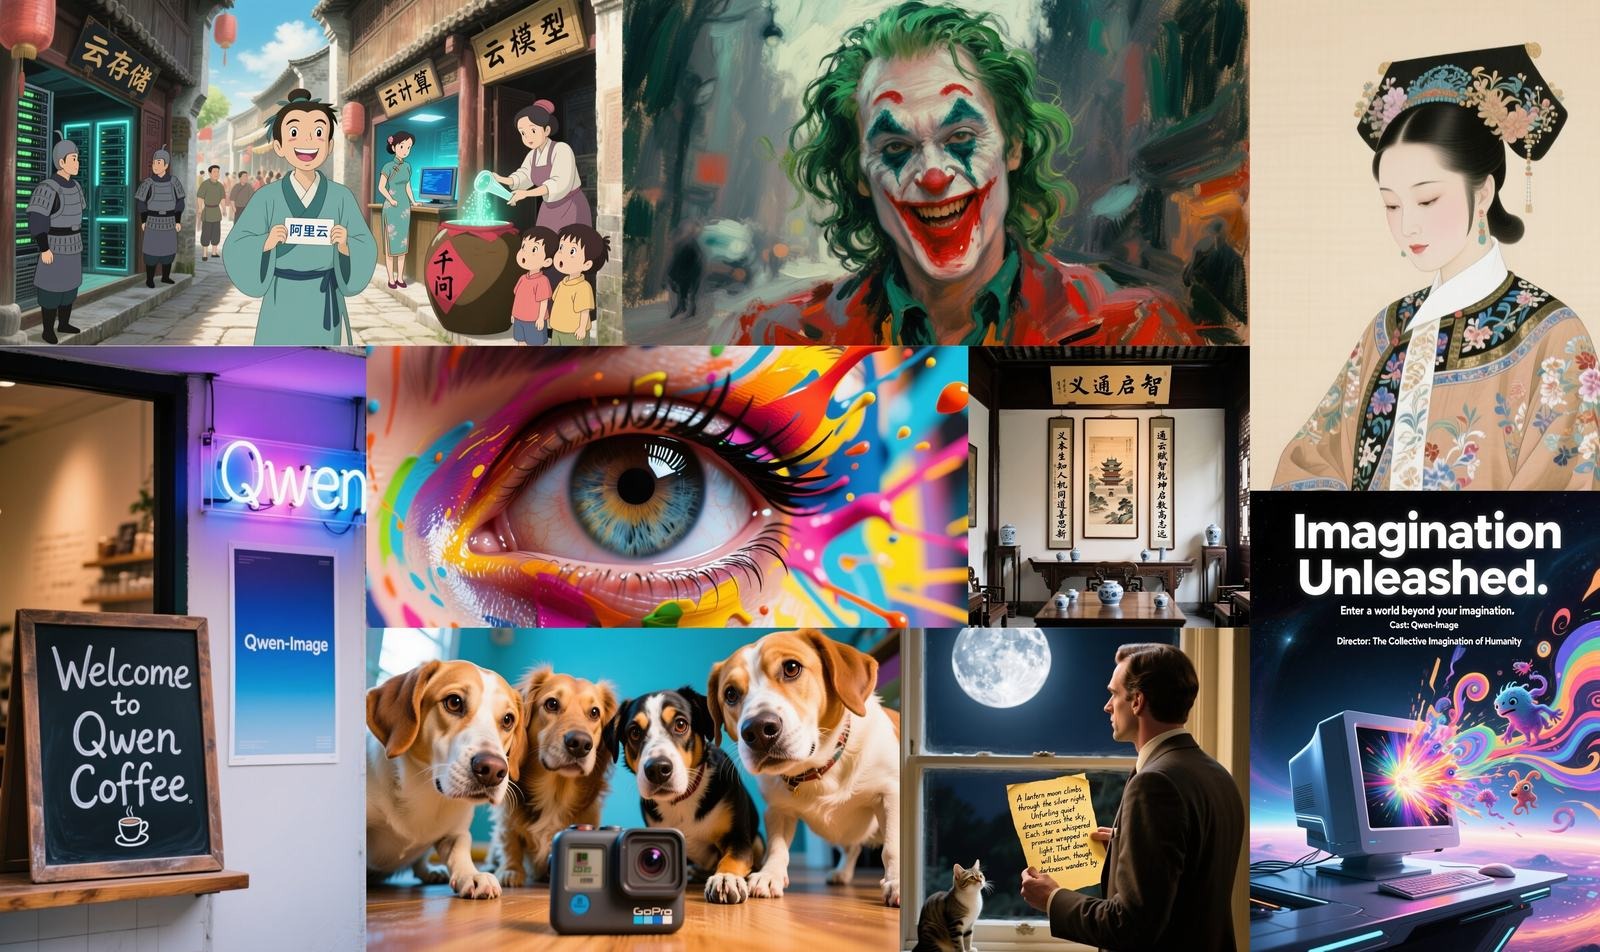
Qwen-Image 官方仓库并未把“消费级 16GB 满载”写成默认配置,但在 Community Support 中写明:ModelScope 的 DiffSynth-Studio 提供逐层卸载,可在 4GB 显存内推理,并支持 FP8 量化和训练。这是官方点名的低显存路径,属于卸载方案,官方没有公布该配置下的速度。8GB 或 12GB 显卡可以把这条当作官方留下的路,但不要把它理解成和 16GB 本机满载一样快。
腾讯混元图像 3.0 是另一套仍在维护的开源方案,但不是普通电脑的菜。官方仓库把它写成原生多模态自回归模型,总参数 80B,每 token 激活 13B,拥有 64 个专家。2026 年 1 月 26 日发布了 Instruct 和蒸馏版 Instruct-Distil,蒸馏版推荐 8 步采样。官方 Models Cards 给出的推荐显存是:基础版大于等于 3 张 80GB 显卡,Instruct 与 Instruct-Distil 大于等于 8 张 80GB 显卡。仓库最近一次推送记录为 2026 年 6 月 23 日。它适合有多卡服务器的团队,不能当作 8 到 24GB 消费级方案来写。
04海外:消费级优先 FLUX.2 [klein] 4B,更大的 [dev] 要看许可证和量化
海外当前最适合自己装在普通电脑上的,是 Black Forest Labs 的 FLUX.2 [klein] 4B。官方 Hugging Face 模型卡写明:这是 4B 参数的整流流模型,把生成和编辑放在同一个紧凑架构里,端到端推理最快可到 1 秒以内,约合 13GB 显存,可在 NVIDIA RTX 3090 / 4070 及以上使用,许可证为 Apache 2.0,并已进入 ComfyUI 与 Diffusers。官方 Diffusers 示例使用 4 步采样,并提供 enable_model_cpu_offload。官方推理仓库 black-forest-labs/flux2 最近一次推送记录为 2026 年 3 月 12 日。
更大的档位要分开看。FLUX.2 [klein] 9B Base 官方写明约 29GB 显存,面向 RTX 4090 及以上,许可证为 FLUX 非商用许可。32B 的 FLUX.2 [dev] 同样是开源权重,但使用非商用许可证;其模型卡建议在 RTX 4090 或 5090 这类消费级卡上参考 Diffusers 文档,示例采用 4-bit 量化加载。Black Forest Labs 知识库还写明:klein 4B 可在 12GB 显存(例如 RTX 3060 12GB)和 32GB 内存上做微调,klein 9B 微调约需 22GB 显存。这是微调硬件,不是把 12GB 写成 [klein] 4B 的满血推理口径。
058GB / 12GB / 16GB / 24GB 该怎么选
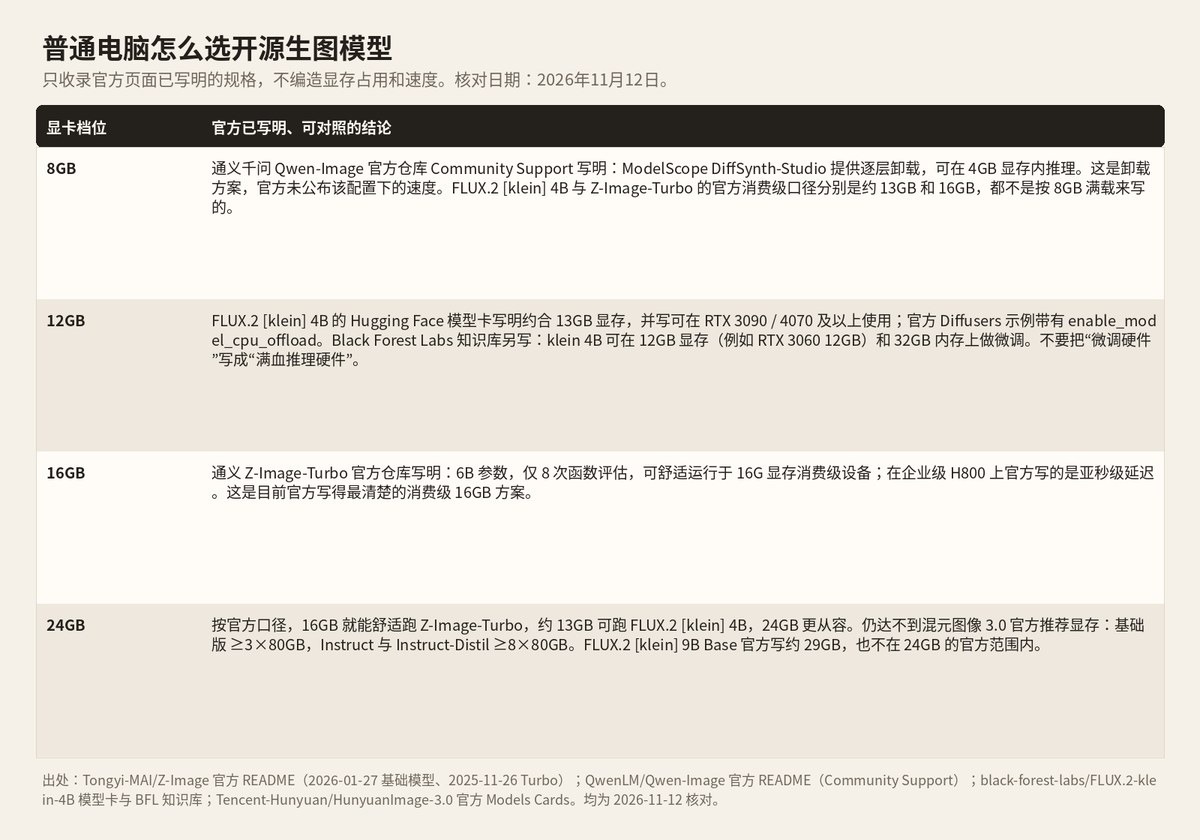
按官方已写明的口径,而不是第三方跑分,可以这样记。8GB:唯一被官方明确写下低显存数字的,是 Qwen-Image 经 DiffSynth-Studio 逐层卸载可在 4GB 内推理,速度未公布;FLUX.2 [klein] 4B 和 Z-Image-Turbo 的官方消费级目标分别是约 13GB 和 16GB。12GB:更接近 [klein] 4B 官方约 13GB 的推理口径,通常要用官方示例中的 CPU 卸载;12GB 在 BFL 知识库里是 klein 4B 的微调硬件,不能直接说成满血推理。16GB:Z-Image-Turbo 官方写可舒适运行,这是目前对消费级写得最清楚的一档,也覆盖了中文文字场景。24GB:跑 Turbo 和 [klein] 4B 会更从容,但仍然到不了混元图像 3.0 官方推荐的多张 80GB,也到不了 [klein] 9B 官方的约 29GB。
06电商场景可以怎么选
- 日常大量出图,并要在画面里写中文标题或促销字:优先 16GB 及以上的 Z-Image-Turbo,走官方仓库或 Diffusers、ComfyUI。
- 需要复杂中文排版,或要把生成和精细编辑放在同一条线上:用已放出权重的 Qwen-Image / Qwen-Image-2512 和对应编辑模型;显存不够时,只能按官方指出的 DiffSynth-Studio 卸载路径来做,并接受官方未公布速度这一事实。
- 要在消费级卡上同时做生成和多参考编辑,并确认 Apache 2.0 的商用条件:看 FLUX.2 [klein] 4B;官方推理口径约 13GB。
- 有多卡服务器、要上混元图像 3.0:按官方模型卡准备 3 张或 8 张 80GB 级显卡,不要把它当成笔记本电脑方案。
- 部署时从官方 GitHub、Hugging Face 或 ModelScope 拉权重,用 ComfyUI 或 Diffusers 固定工作流和种子,先用同一张产品图反复试提示词,再批量出图。商用前核对各模型当前许可证。
一句话收束:2026 年 11 月 12 日能核对到的官方事实是,消费级电脑上,16GB 最适合对上通义 Z-Image-Turbo;约 13GB 及以上可以对上 FLUX.2 [klein] 4B;Qwen-Image 在中文文字和编辑上更强,低显存只能走官方点名的卸载方案;混元图像 3.0 仍然是多卡方案。核对以当天仍有效的各官方仓库和模型卡为准。
收藏与收听进度仅保存在本机。