Claude Fable 5.2简析:写代码和科研是强项,日常工作官方仍建议先用Opus 5.5
Anthropic于2026年11月9日发布Claude Fable 5.2。官方建议大多数编程和知识任务先用Opus 5.5,难任务再换Fable。测评上,Fable 5.2在FrontierCode 2.0(Xhigh)为49.1%、FrontierSWE v2为69.9%,系统卡中SWE-bench Pro为93.0%;远程劳动指数High力度为41.3%,HLE可用工具为74.2%。它不是样样第一:AutomationBench上Gemini 4 Carbon为53.9%,高于Fable的51.4%;AA-Briefcase的Elo则是Opus 5.5更高。网络安全和蛋白质设计高分属于Mythos 5.2。标准价为每百万token输入8美元、输出40美元,比5.1约降两成。本文依据官方介绍页和系统卡整理。
Anthropic在2026年11月9日发布Claude Fable 5.2。它被定位为面向最难技术工作的型号:写代码、推理和视觉都有提升,也适合跑得更久的代理任务。官方自己的用法建议很明确——大多数编程和知识任务,先用日常主力Claude Opus 5.5;任务又大又开放、判断和准确度更要紧时,再换成Fable 5.2。它也可以当顾问或编排者,让更小的模型先做常规活,遇到难题再来咨询它。昨天本栏目已经发过一篇上线说明,本文做简短分析,把强项、弱项和测评数据摊开看,不再重复那些案例。
01先看它是什么,再看该用在哪
Fable和Mythos是同一底层模型。Fable带有更强的网络安全与生物安全护栏,面向全体用户;Mythos面向通过生命科学或网络安全核验计划的机构。开发调用的型号名是claude-fable-5-2,已在Claude平台以及亚马逊云科技、谷歌云、微软云上线。上下文窗口为100万token,最大输出12万8千token;默认思考力度为high,自适应思考始终开启,知识截止到2026年6月。标准价为每百万token输入8美元、输出40美元,比Fable 5.1的10美元和50美元大约下降两成;输出最快约快30%。可选加速模式最高再快约2.5倍,价格为16美元和80美元。使用Fable默认要保留30天数据做安全监测;企业侧另有Frontier Safeguards方案,具体以官方说明和账号设置为准。
对办公室和开发者来说,可以这样理解它的强项:大型、定义还不清楚的软件工程,要跑很多小时甚至数天、需要调度大量子代理的任务,以及科研计算、硬件设计和需要仔细读图表的分析,更对口Fable 5.2。日常改代码、写材料,先用价格大约只有一半的Opus 5.5通常就够。网络安全、生物研究这类工作,Fable的护栏会拦下大多数相关任务,不能把它默认当成已开放的强项;这类需求要走Mythos核验计划,或先看企业侧的Claude Security。
02测评数据:写代码、科研和长程任务领先,但不是样样第一
下面这张对照表,上半部分摘自2026年11月9日Anthropic介绍页,下半部分补充自同日系统卡。橙色数字是该行最高分。分数为各模型最高可用力度,另有标注除外。Fable 5.2、Fable 5.1、Opus 5.5的分数在未另行注明时均带护栏。
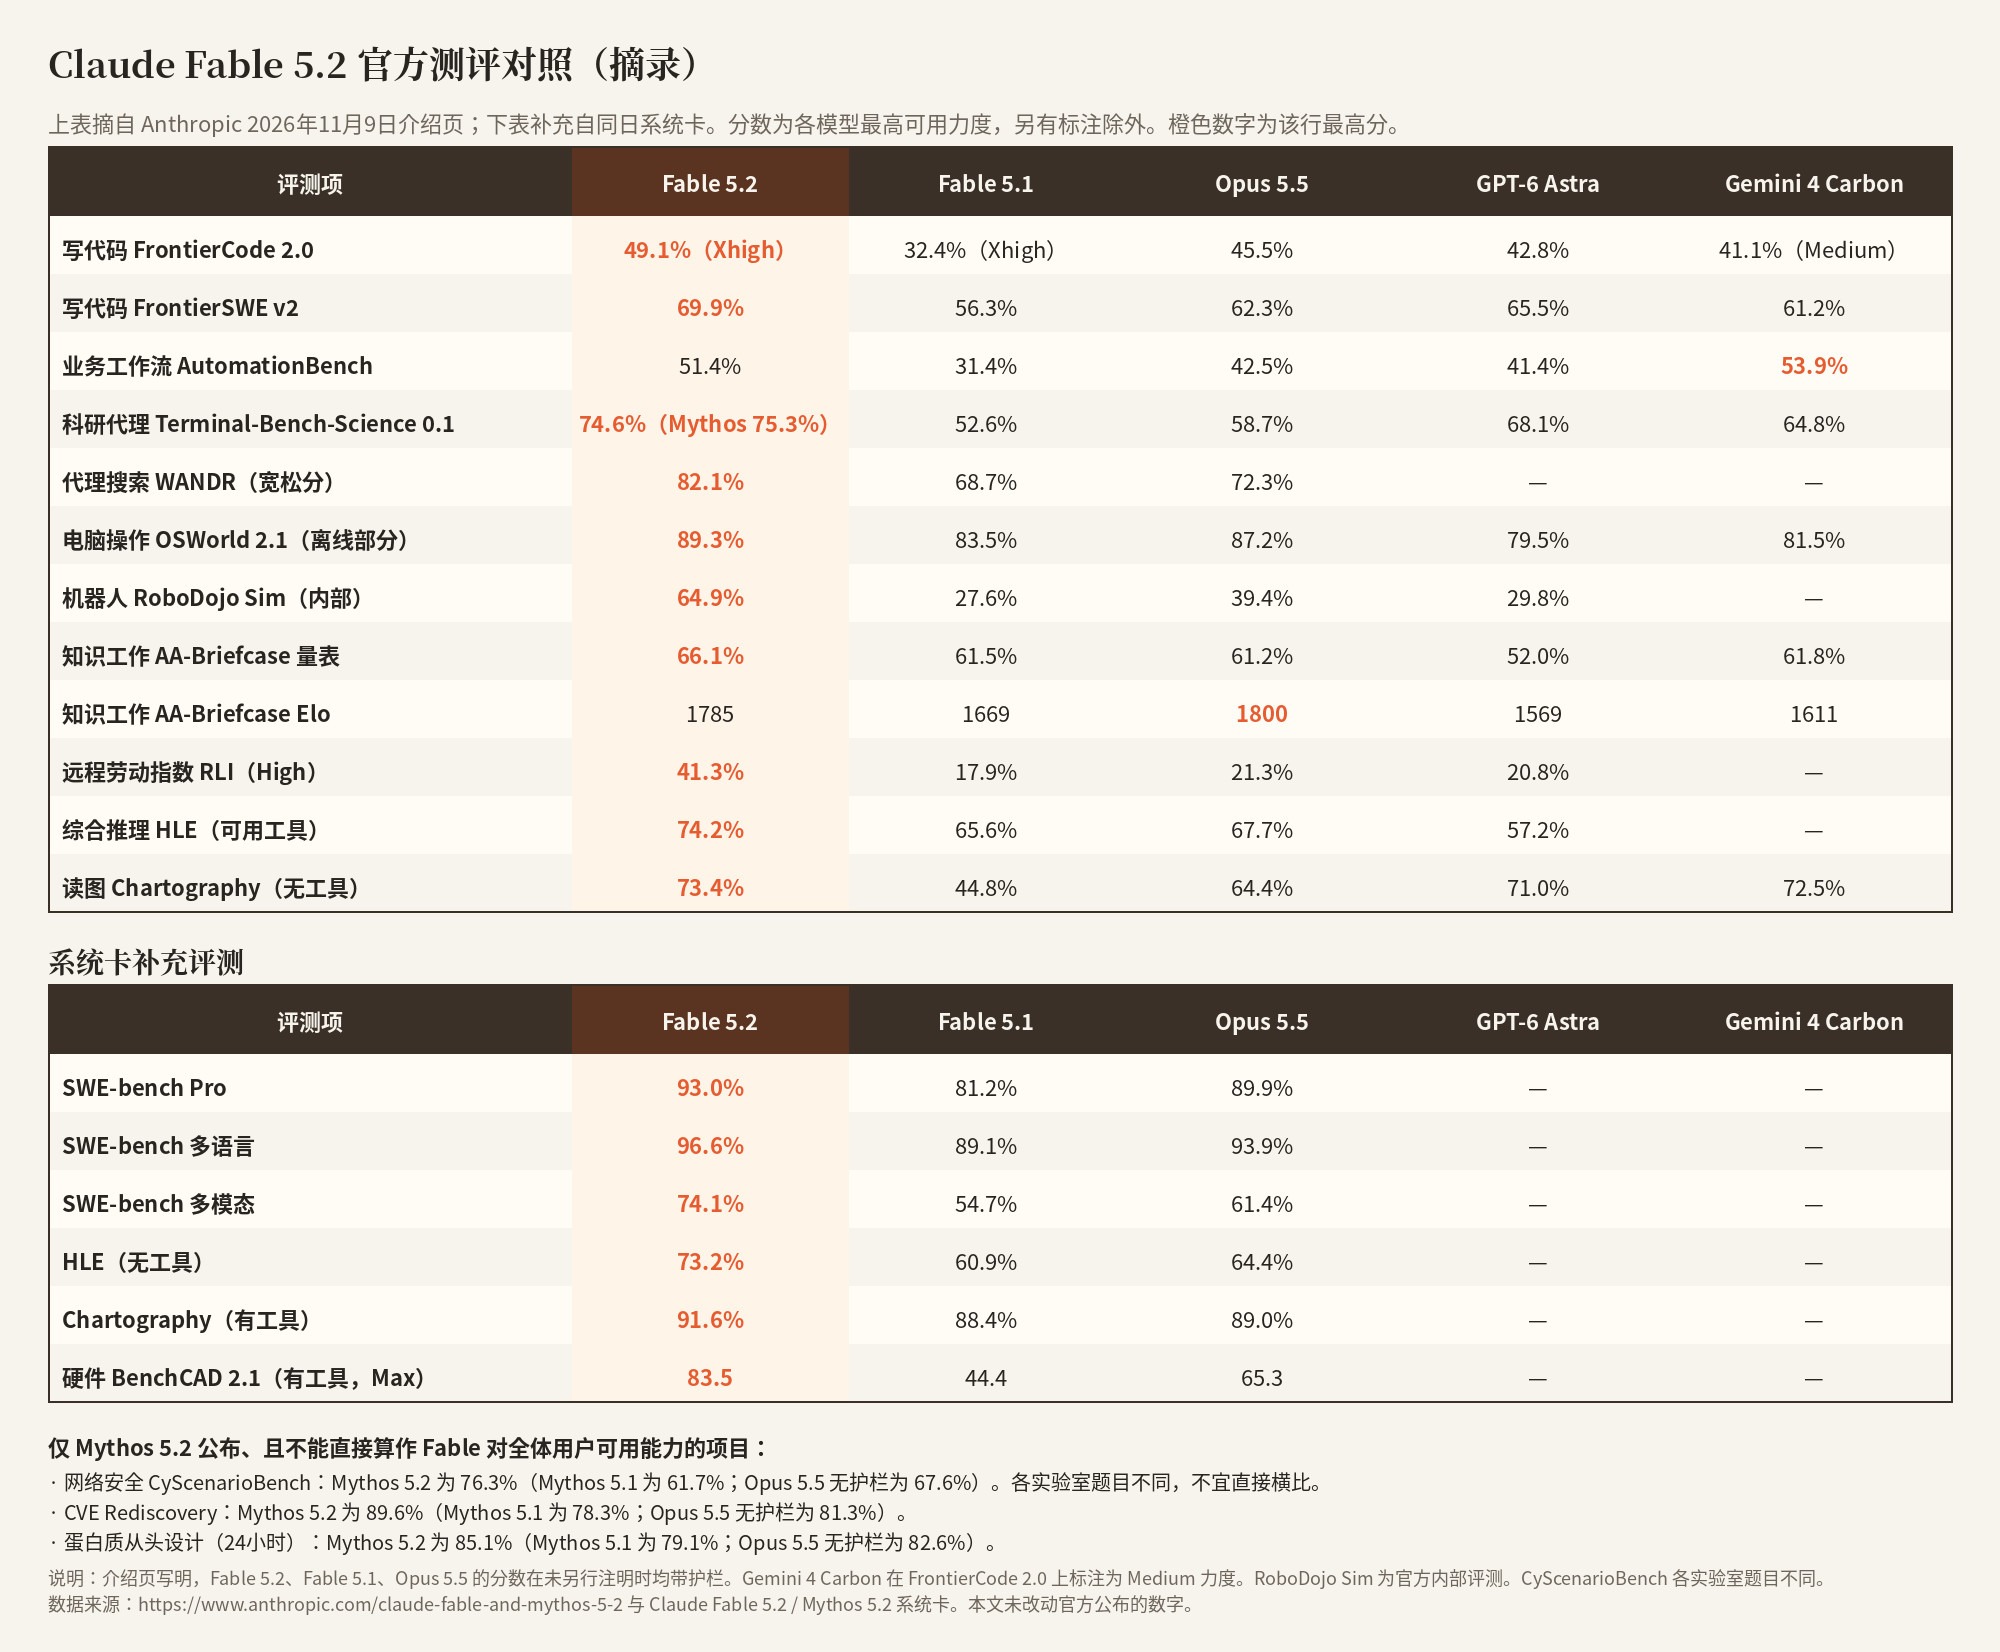
写代码是最清楚的优势。FrontierCode 2.0在Xhigh力度上,Fable 5.2为49.1%,高于Opus 5.5的45.5%,也高于GPT-6 Astra的42.8%。官方还写:在High力度上,它和Opus 5.5的最好成绩大致相当(约45.3%对45.5%),单次任务费用大约只有一半;到Xhigh力度才拉到49.1%。FrontierSWE v2为69.9%,同样高于表中其他型号。系统卡补充的SWE-bench Pro为93.0%、多语言96.6%、多模态74.1%,也都高于Fable 5.1和Opus 5.5。
长程代理和科研、工程也很强。代理搜索WANDR宽松分为82.1%,电脑操作OSWorld 2.1离线部分为89.3%。远程劳动指数在High力度上为41.3%,明显高于Fable 5.1的17.9%和Opus 5.5的21.3%。综合推理Humanity’s Last Exam在可用工具时为74.2%;读图Chartography无工具为73.4%。科研代理Terminal-Bench-Science 0.1上,Fable为74.6%,Mythos为75.3%。硬件评测BenchCAD 2.1在Max力度、可用工具时,Fable为83.5,高于Opus 5.5的65.3和Fable 5.1的44.4。官方还写,在Medium力度的WANDR上,Fable 5.2能打到与Opus 5.5最高分相当的水平,单次费用大约只有四成。
它不是每项都第一,这三点要单独看。业务工作流AutomationBench上,Gemini 4 Carbon为53.9%,高于Fable 5.2的51.4%。知识工作AA-Briefcase的Elo,Opus 5.5为1800,高于Fable的1785;不过量表分Fable为66.1%,略高于Opus的61.2%。机器人RoboDojo Sim上Fable为64.9%,比5.1和对比型号高出不少,但官网写明这是内部评测。另外,网络安全CyScenarioBench、CVE Rediscovery和蛋白质从头设计的高分,属于Mythos 5.2,不能直接算成Fable对全体用户可用的能力。
03可以怎么选
- 日常编程和知识工作,先用Claude Opus 5.5;任务足够大、足够开放,再换claude-fable-5-2。
- 默认走标准价每百万token输入8美元、输出40美元;更在意速度再开加速模式,价格为16美元和80美元,最高约快2.5倍。
- 看测评时要同时看力度和是否启用工具,也要分清哪些分数属于Fable、哪些属于Mythos,哪些是内部评测。
- 网络安全、生物研究不要按Fable已经开放来安排,需走相应核验计划,或先看企业侧的Claude Security。
- 核对以2026年11月9日Anthropic介绍页和系统卡,以及账号里的实际选项为准。
一句话收束:Claude Fable 5.2的核心优势,是把更难的写代码、科研和长程代理任务做完,而且在不少评测里比Opus 5.5更强、单次费用还可以更省;但它更贵,也不是所有榜都第一,官方仍建议大多数日常工作先用Opus 5.5。
收藏与收听进度仅保存在本机。